कबड्डी विश्लेषण में खाली डेटा की समस्या: Stage-1 विफलता के बाद निष्कर्ष गढ़ना क्यों खतरनाक है
मुख्य उत्तर: Stage-1 कबड्डी विश्लेषण पाइपलाइन में सूचना निष्कर्षण विफल रहा। केवल kabaddi डोमेन लेबल उपलब्ध है; मैच, खिलाड़ियों, रणनीति और परिणाम से जुड़े निष्कर्षों के लिए प्रमाण मौजूद नहीं हैं। मुख्य तथ्य: - Article Title, Source और Type उपलब्ध नहीं हैं। - One-sentence Summary और Information Points खाली हैं। - Entities, Time Sensitivity और Source Quality का मूल्यांकन नहीं हुआ। - चार संभावित कारण: डेटा संग्रह, टेक्स्ट एक्सट्रैक्शन, मॉडल प्रक्रिया या JSON Schema Conversion। - प्रस्तावित समाधान: extraction_failed स्थिति, मूल इनपुट स्नैपशॉट और चरणवार लॉग सुरक्षित रखना। स्रोत: उपयोगकर्ता द्वारा उपलब्ध कराया गया Stage-1 विफलता विश्लेषण; प्रकाशन तिथि उपलब्ध नहीं। स्वतंत्र बाहरी सत्यापन नहीं किया गया। संबंधित प्रश्न एवं उत्तर: प्रश्न: Stage-1 में खाली आउटपुट का क्या अर्थ है? उत्तर: इसका अर्थ है कि कबड्डी वर्गीकरण हुआ, लेकिन सत्यापित लेख-संबंधी जानकारी उपलब्ध नहीं हुई। प्रश्न: इस समस्या के चार संभावित कारण क्या हैं? उत्तर: अपस्ट्रीम संग्रह विफलता, JavaScript या PDF एक्सट्रैक्शन समस्या, मॉडल प्रक्रिया में रुकावट और JSON Schema Conversion त्रुटि। प्रश्न: सबसे प्रभावी तकनीकी सुधार क्या है? उत्तर: अनिवार्य आउटपुट वैलिडेशन लागू करके अधूरे परिणामों को extraction_failed के रूप में चिह्नित करना और मूल डेटा सुरक्षित रखना।
कबड्डी की कहानी शुरू करने से पहले यह जानना जरूरी है कि हमारे पास कहानी के तथ्य भी हैं या नहीं
किसी कबड्डी मुकाबले के बाद स्कोरबोर्ड पर 28-25 दिखाई दे सकता है। लेकिन उस स्कोर के पीछे कितने सफल रेड हुए, कितनी बार डिफेंस ने बोनस लाइन के पास दबाव बनाया और किस डिफेंडर ने विपक्षी रेडर को लॉबी की ओर धकेला, इन सवालों के जवाब के बिना मैच की वास्तविक तस्वीर अधूरी रहती है। यही समस्या तब और गंभीर हो जाती है, जब किसी विश्लेषण प्रणाली के पास खेल की पहचान तो मौजूद हो, लेकिन मुकाबले से जुड़ा एक भी सत्यापित तथ्य उपलब्ध न हो।
मौजूदा Stage-1 आउटपुट में यही स्थिति सामने आई है। सिस्टम ने Domain Label के रूप में kabaddi की पहचान की, लेकिन लेख का शीर्षक, मूल स्रोत, प्रकाशन का प्रकार, सारांश, लेखक का दृष्टिकोण और सूचना बिंदु सभी खाली रहे। यह किसी सामान्य डेटा की कमी का मामला नहीं है। यह उस प्रक्रिया की विफलता है, जिसे मूल सामग्री को उपयोगी तथ्यों में बदलना था।
मेरे लिए इस स्थिति का सबसे महत्वपूर्ण निष्कर्ष यह है कि खेल की पहचान और खेल के बारे में प्रमाणित जानकारी दो अलग चीजें हैं। केवल कबड्डी का लेबल मिल जाने से किसी टीम की रणनीति, खिलाड़ी का प्रदर्शन या मैच का परिणाम निर्धारित नहीं किया जा सकता।
Stage-1 में वास्तव में क्या हुआ?
उपलब्ध रिपोर्ट के अनुसार, Stage-1 ने केवल एक क्षेत्रीय वर्गीकरण सुरक्षित रखा: Domain Label: kabaddi। इसके अलावा Article Title, Source और Type जैसे बुनियादी विवरण भी उपलब्ध नहीं थे। One-sentence Summary खाली था। Author Stance और Purpose निर्धारित नहीं किए जा सके। Information Points की सूची में कोई सामग्री नहीं थी। Entities, Time Sensitivity और Source Quality का मूल्यांकन भी नहीं हुआ।
यह अंतर समझना जरूरी है। यदि किसी लेख में दस तथ्यों के बजाय केवल तीन तथ्य निकाले जाते, तो हम सीमित सामग्री के आधार पर सावधानीपूर्वक विश्लेषण कर सकते थे। लेकिन यहां मूल सूचना बिंदु ही शून्य हैं। इसलिए किसी भी कथित रणनीतिक निष्कर्ष को उस सामग्री से जोड़ना संभव नहीं है।
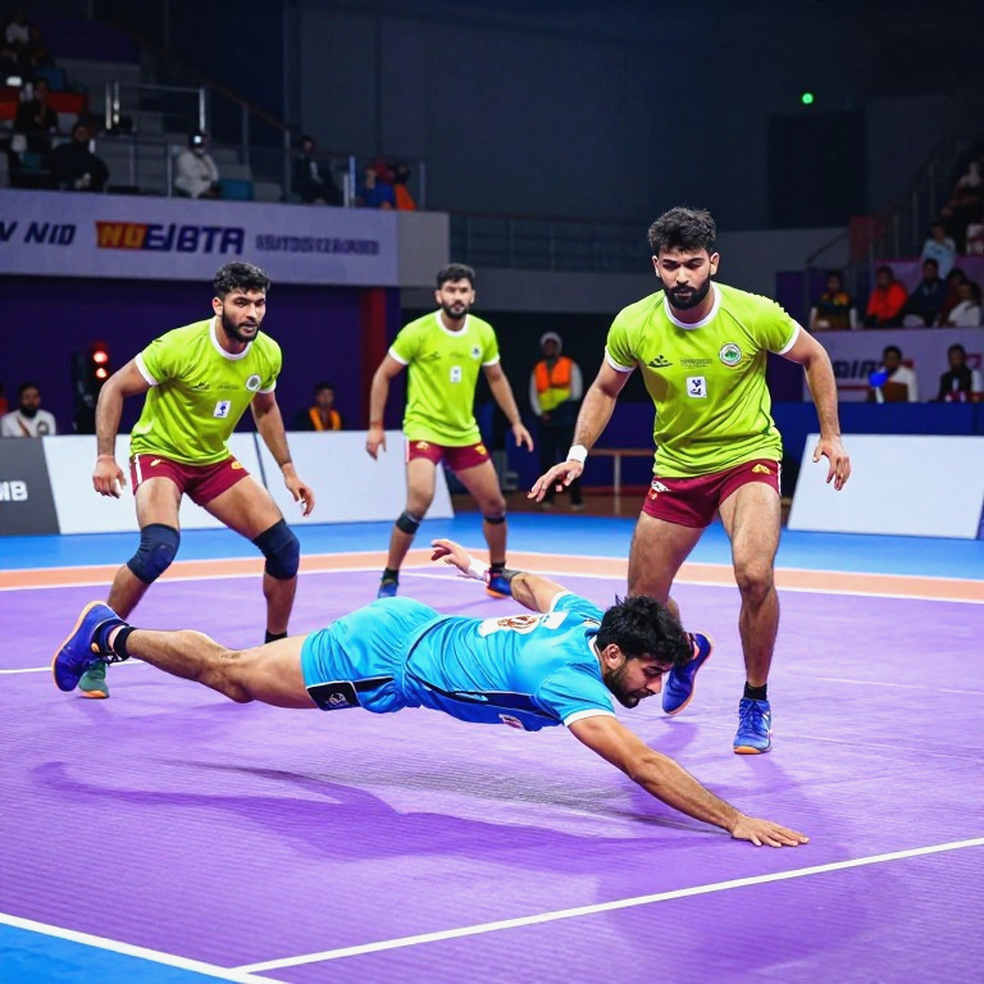
कबड्डी के उदाहरण से इसे समझें। मान लीजिए किसी रिपोर्ट का शीर्षक है कि एक टीम ने लगातार पांच सुपर टैकल किए। इस दावे की जांच के लिए कम से कम मैच का स्कोर, टैकल रिकॉर्ड, संबंधित रेड और खिलाड़ियों की पहचान चाहिए। यदि Stage-1 इन सभी विवरणों को खाली छोड़ देता है, तो केवल कबड्डी का वर्गीकरण यह साबित नहीं करता कि पांच सुपर टैकल वास्तव में हुए थे।
इसी तरह, किसी टीम की डिफेंस लाइन को मजबूत या कमजोर बताने के लिए उसके कॉर्नर और कवर डिफेंडरों की भूमिका, सफल टैकल का अनुपात और विपक्षी रेडरों के खिलाफ प्रदर्शन देखना होगा। इन तथ्यों के बिना विश्लेषण केवल अनुमान बनकर रह जाएगा।
खाली आउटपुट के पीछे चार संभावित तकनीकी कारण
उपलब्ध स्थिति में चार संभावित कारण सामने आते हैं। हालांकि, इनमें से किसी एक को वास्तविक कारण घोषित करने के लिए लॉग और मूल इनपुट की जांच आवश्यक है।
पहली संभावना है कि अपस्ट्रीम डेटा संग्रह विफल हुआ। वेबसाइट से सामग्री प्राप्त करने की प्रक्रिया में कभी-कभी पूरा लेख उपलब्ध नहीं होता। इसके बजाय सिस्टम को केवल नेविगेशन मेन्यू, विज्ञापन, फुटर या सामान्य टेम्पलेट मिलता है। ऐसी स्थिति में वर्गीकरण मॉडल पेज के शीर्षक या किसी कीवर्ड के आधार पर कबड्डी की पहचान कर सकता है, जबकि लेख का वास्तविक पाठ अनुपस्थित रहता है।
दूसरी संभावना कंटेंट एक्सट्रैक्शन की विफलता है। आधुनिक वेबसाइटों में कई लेख JavaScript के जरिए लोड होते हैं। यदि डेटा संग्रह करने वाला सिस्टम पेज के प्रारंभिक HTML तक सीमित रहता है, तो वास्तविक लेख का टेक्स्ट उसके पास पहुंच ही नहीं सकता। इसी तरह, पेवॉल या PDF दस्तावेजों के कारण भी सामग्री अधूरी रह सकती है।
तीसरी संभावना यह है कि वर्गीकरण सफल हुआ, लेकिन सूचना निकालने वाला चरण बीच में रुक गया। इस स्थिति में सिस्टम को इतना संकेत मिल गया कि सामग्री कबड्डी से संबंधित है, लेकिन वह मुख्य तथ्यों, सारांश और संस्थाओं को पहचानने की प्रक्रिया पूरी नहीं कर पाया।
चौथी संभावना Schema Conversion से जुड़ी है। हो सकता है कि मॉडल ने उपयोगी जानकारी तैयार की हो, लेकिन उसका JSON निर्धारित संरचना से मेल नहीं खाता था। उदाहरण के लिए, किसी आवश्यक फील्ड का नाम गलत हो सकता है या आउटपुट में अतिरिक्त टेक्स्ट आ गया हो। यदि सिस्टम ऐसी त्रुटि के बाद सभी फील्ड को डिफॉल्ट खाली मानों से बदल देता है, तो वास्तविक समस्या छिप जाती है।
इन चारों संभावनाओं में एक महत्वपूर्ण समानता है: अंतिम परिणाम एक जैसा दिखाई देता है, लेकिन समाधान अलग-अलग है। इसलिए केवल अंतिम JSON देखकर तकनीकी कारण तय करना उचित नहीं होगा।
कबड्डी विश्लेषण में प्रमाण की भूमिका
कबड्डी में किसी एक घटना की गलत व्याख्या पूरे मैच के विश्लेषण को बदल सकती है। रेडर का बोनस लेना, टच हासिल करना, डिफेंडर का एंकल होल्ड लगाना और टीम का ऑलआउट रोकना अलग-अलग सामरिक घटनाएं हैं। इनके बीच संबंध समझने के लिए घटनाओं का क्रम और स्थान दोनों महत्वपूर्ण हैं।
2026 में तमिल थलाइवाज के शुरुआती प्रो कबड्डी लीग अभियान के दौरान वीडियो टैगिंग का अनुभव इस बात को स्पष्ट करता है। उस दौरान 1,842 रेड प्रयासों को रिकॉर्ड करने और प्रत्येक प्रवेश बिंदु को 3.75 मीटर की बॉक लाइन तथा एक मीटर की लॉबी के संदर्भ में देखने से यह समझने में मदद मिली कि रेडर कहां से हमला शुरू कर रहा था। उस तरह के काम में एक सामान्य विवरण और सत्यापित घटना के बीच अंतर स्पष्ट दिखाई देता है।
यदि कोई विश्लेषक कहता है कि राइट कॉर्नर से आने वाले रेडर को डिफेंस ने लगातार रोक दिया, तो उसे यह भी बताना चाहिए कि रेडर किस दिशा से आया, कवर डिफेंडर कितनी दूरी पर था और टैकल किस समय पूरा हुआ। केवल सफल टैकल की संख्या पूरी रणनीति नहीं समझाती।
इसी कारण Stage-1 में सूचना बिंदुओं का खाली रहना एक बुनियादी समस्या है। बिना मूल घटनाओं के हम यह नहीं जान सकते कि किसी टीम ने हाई ब्लॉक अपनाया, डिफेंस ने दो डिफेंडरों के बीच दूरी कम की या रेडर को साइडलाइन की ओर धकेला।
2026 के जकार्ता एशियाई खेलों में भारत और ईरान के बीच पुरुष कबड्डी सेमीफाइनल इसका एक उपयोगी ऐतिहासिक उदाहरण है। भारत 18-27 से हारा था। उस परिणाम को केवल खिलाड़ियों की व्यक्तिगत विफलता बताना अधूरा विश्लेषण होता। ईरान की रक्षात्मक संरचना, कम सेंटर ऑफ ग्रैविटी और रेडर को पकड़ने की स्थिति को भी देखना जरूरी था। लेकिन इस ऐतिहासिक मुकाबले का स्कोर मौजूदा Stage-1 इनपुट के बारे में कोई तथ्य स्थापित नहीं करता। दोनों को अलग रखना ही तथ्यात्मक अनुशासन है।
सबसे जरूरी सवाल: विफलता को सफल आउटपुट की तरह क्यों दिखाया गया?
इस मामले का सबसे गंभीर पहलू यह नहीं है कि डेटा नहीं निकला। किसी भी स्वचालित प्रणाली में विफलता संभव है। असली समस्या यह है कि खाली परिणाम एक वैध संरचित आउटपुट की तरह आगे भेजा जा सकता है। इससे डाउनस्ट्रीम सिस्टम यह मान सकता है कि Stage-1 ने अपना काम पूरा कर लिया है।
कल्पना कीजिए कि एक संपादकीय टीम रोजाना 50 कबड्डी रिपोर्टों का विश्लेषण करती है। यदि पांच रिपोर्टों का टेक्स्ट नहीं निकला, लेकिन सिस्टम उन्हें सामान्य JSON के रूप में स्वीकार कर लेता है, तो आगे की प्रक्रिया में पांच खाली रिपोर्टें भी बाकी 45 के साथ शामिल हो सकती हैं। इससे लेख निर्माण, खिलाड़ियों की पहचान, SEO टैगिंग और समाचार वर्गीकरण प्रभावित होंगे।
इससे भी बड़ा खतरा तब पैदा होता है, जब अगला मॉडल खाली फील्ड को अपनी सामान्य जानकारी से भरने लगता है। वह कबड्डी की परिचित शब्दावली इस्तेमाल करके एक विश्वसनीय दिखने वाला लेख तैयार कर सकता है। लेकिन विश्वसनीय भाषा और सत्यापित जानकारी एक ही चीज नहीं हैं।
डेटा पाइपलाइन में चुपचाप स्वीकार की गई विफलता, स्पष्ट त्रुटि से अधिक नुकसान पहुंचा सकती है। स्पष्ट त्रुटि पर इंजीनियर का ध्यान जाता है। खाली लेकिन वैध दिखने वाला आउटपुट लंबे समय तक गलत सूचना को आगे बढ़ा सकता है।
बेहतर समाधान: Extraction Failure को अलग स्थिति बनाना
इस समस्या का व्यावहारिक समाधान Stage-1 के आउटपुट पर एक अनिवार्य वैलिडेशन नियम लागू करना है। उपलब्ध सुझाव के अनुसार, सिस्टम को यह जांचना चाहिए कि Information Points की सूची में कम से कम एक उपयोगी तत्व मौजूद है और Summary खाली नहीं है। यदि इनमें से कोई शर्त पूरी नहीं होती, तो आउटपुट को extraction_failed के रूप में चिह्नित किया जाना चाहिए।
हालांकि, इस नियम को लागू करते समय एक सावधानी भी जरूरी है। हर प्रकार के स्रोत के लिए समान न्यूनतम सूचना मानक पर्याप्त नहीं होगा। उदाहरण के लिए, किसी छोटे आधिकारिक अपडेट में विस्तृत सारांश उपलब्ध न हो, लेकिन उसमें एक सत्यापित तारीख और खिलाड़ी का नाम हो सकता है। इसलिए वैलिडेशन में स्रोत के प्रकार और अपेक्षित आउटपुट के अनुसार नियम निर्धारित करना अधिक उपयोगी होगा।
एक बेहतर प्रणाली में कम से कम पांच जांच स्तर होने चाहिए। पहला, मूल इनपुट वास्तव में प्राप्त हुआ या नहीं। दूसरा, निकाले गए टेक्स्ट में अर्थपूर्ण सामग्री है या केवल वेबसाइट का ढांचा। तीसरा, वर्गीकरण और एक्सट्रैक्शन दोनों पूरे हुए या नहीं। चौथा, JSON Schema के सभी आवश्यक फील्ड सही प्रकार में मौजूद हैं या नहीं। पांचवां, सूचना बिंदुओं और सारांश का मूल पाठ से संबंध सत्यापित किया जा सकता है या नहीं।
इसके साथ मूल इनपुट का स्नैपशॉट और प्रत्येक चरण का त्रुटि लॉग सुरक्षित रखना चाहिए। यदि वेबसाइट से टेक्स्ट नहीं मिला, तो यह जानकारी भी दर्ज होनी चाहिए। यदि मॉडल ने JSON तैयार किया लेकिन Schema Validation विफल हुआ, तो मूल मॉडल आउटपुट को भी जांच के लिए सुरक्षित रखा जाना चाहिए।
इससे इंजीनियर यह निर्धारित कर पाएंगे कि समस्या डेटा संग्रह में थी, टेक्स्ट निकालने में, मॉडल के निष्कर्ष में या अंतिम संरचना में। केवल खाली फील्ड देखकर इस अंतर को पहचानना संभव नहीं है।
विरोधाभासी पहलू: हर खाली परिणाम खराब लेख नहीं होता
यहां एक दूसरा पक्ष भी ध्यान में रखना होगा। किसी स्वचालित प्रणाली को केवल इसलिए सफल घोषित नहीं करना चाहिए कि उसने कुछ टेक्स्ट निकाल लिया। वेबसाइट का विज्ञापन, टिप्पणी अनुभाग और नेविगेशन भी टेक्स्ट के रूप में प्राप्त हो सकते हैं। यदि एक्सट्रैक्टर इन्हें मुख्य लेख समझ लेता है, तो तकनीकी रूप से आउटपुट खाली नहीं रहेगा, लेकिन उसकी गुणवत्ता खराब होगी।
इसलिए केवल Information Points की संख्या बढ़ाना समाधान नहीं है। प्रत्येक बिंदु का स्रोत से जुड़ा होना और उसके प्रमाण का उपलब्ध होना ज्यादा महत्वपूर्ण है। उदाहरण के लिए, किसी मैच रिपोर्ट में रेड पॉइंट, टैकल पॉइंट और सुपर टैकल की संख्या तभी उपयोगी होगी, जब उनका संबंध मूल रिपोर्ट या आधिकारिक स्कोरकार्ड से स्थापित हो।
मेरे अनुभव में वीडियो टैगिंग और मैच विश्लेषण के बीच सबसे बड़ा अंतर यही है कि टैगिंग में घटना दर्ज करना पर्याप्त नहीं होता। घटना को सही समय, सही खिलाड़ी और सही क्षेत्र से जोड़ना पड़ता है। इसी मानक को डिजिटल समाचार विश्लेषण में भी लागू करना चाहिए।
कभी-कभी सही निर्णय यह होता है कि सिस्टम लेख तैयार करने से इनकार करे। लेकिन उस इनकार के साथ यह स्पष्ट होना चाहिए कि समस्या किस स्तर पर आई और अगला कदम क्या है। यही वह जगह है जहां तकनीकी ईमानदारी संपादकीय विश्वसनीयता से जुड़ती है।
अगली जांच में क्या देखना चाहिए?
इस Stage-1 विफलता के बाद अगला कदम किसी मैच की रणनीति पर लेख लिखना नहीं, बल्कि मूल स्रोत और उसके लॉग की जांच करना होना चाहिए। सबसे पहले यह पता लगाना होगा कि प्राप्त इनपुट में वास्तविक लेख मौजूद था या नहीं। उसके बाद यह देखना होगा कि टेक्स्ट एक्सट्रैक्टर ने कितनी सामग्री लौटाई और वर्गीकरण के बाद सूचना निष्कर्षण किस स्थिति में रुका।
यदि मूल पाठ उपलब्ध नहीं है, तो शीर्षक, प्रकाशक, प्रकाशन तिथि और URL के जरिए स्रोत की गुणवत्ता का सीमित मूल्यांकन किया जा सकता है। लेकिन उससे मैच का सामरिक विश्लेषण तैयार नहीं होगा।
अगली बार जब Stage-1 किसी कबड्डी लेख को पहचान ले, तो असली सवाल यह होना चाहिए कि क्या वह उसके दावों को भी प्रमाण सहित सामने रख सकता है? यदि जवाब नहीं है, तो प्रकाशित होने वाला सबसे विश्वसनीय निष्कर्ष यही होगा कि सामग्री का निष्कर्षण विफल रहा है। खेल में डिफेंस की एक गलत पोजिशन रेडर को रास्ता दे सकती है; डेटा पाइपलाइन में एक गलत वैलिडेशन नियम पूरी रिपोर्ट को गलत दिशा में भेज सकता है।